一文详尽如何破解车联网数据采集存储难题 数据处理和存储支持服务全景解析
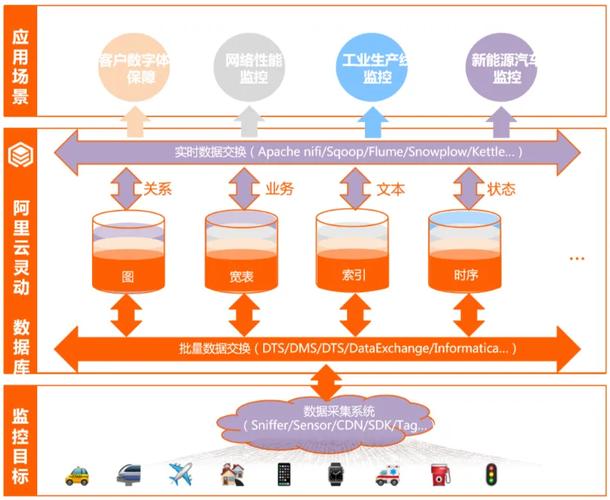
引言\n\n随着智能网联汽车的快速普及,单车日均产生的数据量已从早期的几十MB跃升至数十GB。从感知传感器的原始点云、CAN总线报文,到座舱语音、高位视频与高精定位轨迹,车联网数据在规模、速度和多样性三个维度上同时膨胀。海量数据既是智能驾驶算法迭代与用户服务升级的核心燃料,也给采集、传输、处理与存储带来了系统性挑战。如何构建一套可靠、高效且合规的数据处理与存储支持服务体系,已成为车企与出行服务商必须回答的基础命题。\n\n## 一、车联网数据采集面临的核心难题\n\n1. 数据源异构且采集接口碎片化。 一辆智能汽车同时接入毫米波雷达、激光雷达、摄像头、超声波传感器、GPS/IMU以及数十个ECU控制器,各数据源的时间戳基准、编码格式与采样频率并不统一。若采集端缺乏统一的接入规范与时钟同步机制,后续的数据对齐与融合分析将举步维艰。\n\n2. 车端算力与带宽受限。 车辆在行驶过程中回传数据依赖蜂窝网络,带宽波动大、资费成本高。原始数据全部上行既不经济也不现实,必须在车端完成初步清洗、压缩与关键片段筛选,但这又要求车端具备可信的算力资源与轻量化算法部署能力。\n\n3. 采集触发策略难以平衡。 全量采集造成存储与传输浪费,事件触发采集又容易遗漏长尾场景。尤其在自动驾驶研发中,挖掘“边缘案例”(Corner Case)需要采集系统具备语义级的数据打标与自动触发能力。\n\n## 二、存储层面不可回避的三重压力\n\n1. 容量与时长的矛盾。 根据多地智能网联汽车数据管理相关规定,事故前后一定时段的关键数据需完整留存备份,研发数据亦需长期归档支撑模型迭代。数据保留周期从数月至数年不等,线性扩容的存储投入难以持续。\n\n2. 访问性能的分层需求。 实时仿真与标注训练要求对近期热数据实现毫秒到秒级读取,而历史冷数据在合规审查时才被索引访问。单一介质无法同时满足成本与性能,必须引入冷热分层与生命周期管理策略。\n\n3. 合规与安全约束。 车联网数据涉及地理位置、生物特征与行驶轨迹等敏感信息,境内存储、分类分级、加密保护与访问审计均是硬性要求。存储架构需在分布式扩展与安全隔离之间取得平衡。\n\n## 三、系统化破解路径:数据处理与存储支持服务\n\n针对上述痛点,行业内正在形成以“边缘—云端协同、算子化处理、分层化存储、服务化输出”为主线的解决框架。\n\n### (一)统一数据接入与边缘预处理\n\n在车端部署轻量化数据代理,统一适配各类传感器与总线协议,完成时间同步、协议转换与初步降噪。同时落地两类关键能力:其一是可配置的事件触发规则引擎,基于速度突变、AEB触发、接管行为等信号自动裁剪关键前后片段;其二是车端数据脱敏与籍贯化处理,确保敏感字段在上行前即完成最小化治理。边缘网关再将非必要静默数据按策略暂存、按需回传,从而在同等的流量成本下把高价值数据传回云端。\n\n### (二)算子化的数据处理管线\n\n数据抵达云端后,须经过解析、清洗、对齐、标注切分与特征提取等流水线处理。建议将每一步封装为可复用的Streaming算子,通过Serverless数据流任务进行编排,使批处理与流处理共享同一套元数据模型。示例性的逻辑如下:\n\n`python\nfrom cniotstreaming import PipelineClient\n\nconfig = {\n \
如若转载,请注明出处:http://www.vxzeexo.com/product/33.html
更新时间:2026-11-01 15:54:26